
El MTBF, tiempo medio entre fallos, es el tiempo de funcionamiento dividido por el número de fallos. El MTTR describe el tiempo promedio de reparación o recuperación; esta guía mide desde el fallo del equipo hasta su retorno al servicio y registra el mantenimiento activo por separado. Con 140 horas de funcionamiento, cuatro fallos y ocho horas de restauración, el MTBF es 35 horas y el MTTR es dos horas. La disponibilidad del OEE utiliza en tu lugar el tiempo de producción planificado, por lo que también refleja otras paradas registradas. Acuerda sobre los relojes antes de comparar equipos.
Calcula ambos indicadores a partir de un registro de horas de funcionamiento y un registro de fallos
Separa el tiempo dedicado al mantenimiento del tiempo total para restaurar el servicio
Comprende por qué las mismas pérdidas por fallos pueden producir cifras de disponibilidad diferentes
Las horas planificadas, de funcionamiento y perdidas detrás del ejemplo. Haz una copia y reemplace los valores ilustrativos.
CSVRegistro de eventos de fallos trabajadoCuatro fallos con marcas de tiempo y tiempo de mantenimiento activo registrado por separado. Úselo junto con el registro de horas de funcionamiento.
Lo que te dicen el MTBF y el MTTR
Dos equipos pueden ambos reportar un MTTR de dos horas y estar midiendo cosas diferentes. Uno inicia el reloj cuando un técnico comienza a trabajar. El otro lo inicia cuando la máquina fallo. Una larga espera por una pieza de repuesto aparece en solo uno de esos informes.
Escribe la definición junto al resultado. Aquí MTTR cubre desde el fallo hasta la vuelta al servicio. El mantenimiento activo mide diagnóstico, reparación y comprobación; respuesta y esperas se registran por separado. IEEE también describe la restauración del servicio, pero debes declarar tu convención.
| Métrica | Cálculo utilizado aquí | Pregunta que ayuda a responder |
|---|---|---|
| MTBF | Horas de operación ÷ fallos del equipo | ¿Cuánto tiempo de funcionamiento obtenemos entre fallos? |
| MTTR | Horas de fallo al servicio ÷ restauraciones completadas | ¿Cuánto tiempo nos toma devolver el equipo? |
| Tiempo medio de mantenimiento activo | Horas activas medidas ÷ restauraciones completadas | ¿Qué parte de ese tiempo es trabajo real de mantenimiento? |
Registra las horas de operación junto con los fallos
Un registro de fallos no puede decirte cuánto tiempo funcionó la máquina. Mantén un registro separado de horas de operación para el mismo activo y ventana de informe, incluyendo equipos que no tuvieron fallos. Usa un contador de tiempo de ejecución verificado o un historial reconciliado del estado de producción.
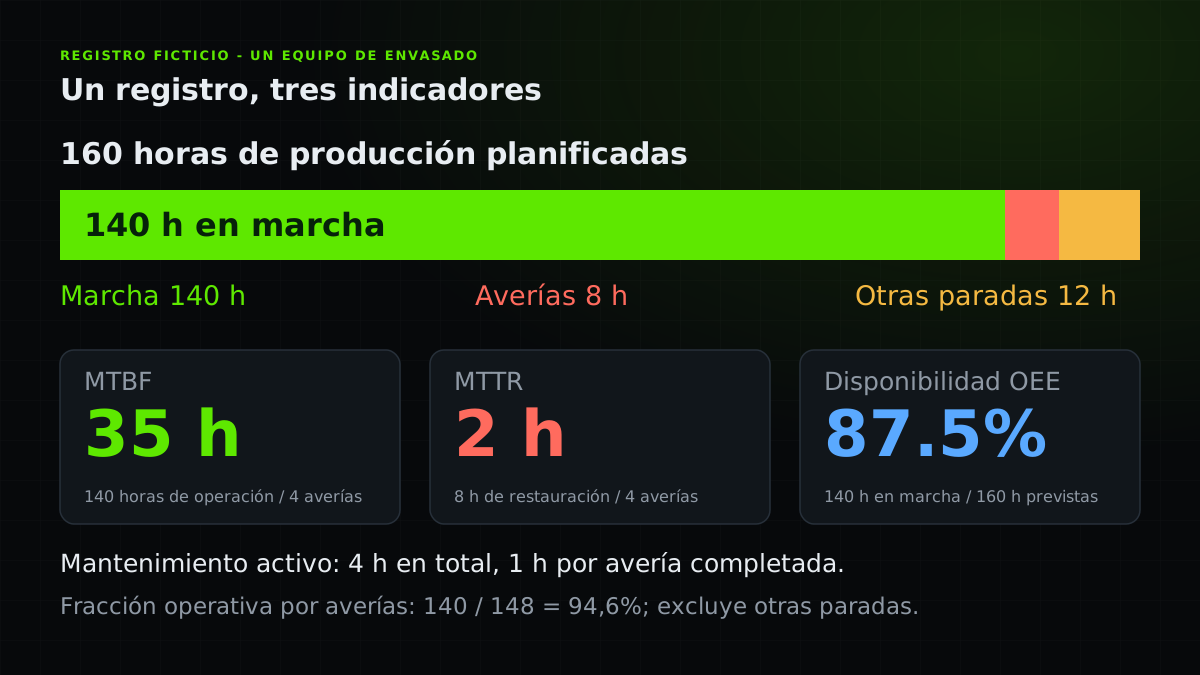
Nuestro activo de embalaje ilustrativo, PKG-01, tiene diez días de producción programados de 16 horas: 160 horas de producción planificadas. Funciona durante 140 horas, pierde ocho horas por fallos en el equipo y doce horas por otras paradas. Las tres partes suman 160. Se excluyen las noches y los tiempos no programados fuera de esos periodos de producción.
| Ítem registrado | Valor de ejemplo | Por qué es importante |
|---|---|---|
| Activo y ventana de informe | PKG-01, 7-18 de septiembre de 2026 | Coincidir ambos registros con el mismo equipo y fechas |
| Tiempo de producción programado | 160 h | El denominador de disponibilidad del OEE |
| Tiempo operativo | 140 h | La exposición al MTBF, verificada contra el registro de tiempo de ejecución |
| Tiempo de parada por falla | 8 h | Cuatro fallos completadas, sin superposición |
| Otro tiempo de parada | 12 h | 8 h de cambios de referencia y 4 h de faltantes de material |
Construye un registro de fallos con puntos de inicio y fin claros
Acuerda qué se considera un fallo del equipo: pérdida de la función requerida del equipo. Una falta de material o un cambio de referencia planificado pueden detener la producción sin constituir un fallo del equipo. Mantén separada la categoría de parada y el síntoma observado de una causa que aún no ha sido confirmada.
Registra identificadores de evento y equipo, hora del fallo, hora de vuelta al servicio y mantenimiento activo medido. Conserva zonas horarias, referencias a las pruebas y una regla coherente de retorno. Si se espera por un repuesto, puede haber varios intervalos de trabajo activo dentro de un fallo; una sola hora de inicio de reparación no los recoge.
Estos cuatro eventos ilustrativos están completamente finalizados dentro de la misma ventana de informe. Sus marcas de tiempo están en el CSV descargable. El otro tiempo de restauración es el remanente después del trabajo activo, que puede incluir respuestas, esperas o retrasos de liberación. La tabla por sí sola no puede indicarnos qué retraso corregir.
| Evento | Síntoma registrado | Desde fallo hasta servicio | Mantenimiento activo | Otro tiempo de restauración |
|---|---|---|---|---|
| F01 | Motor detenido | 2 h | 1 h | 1 h |
| F02 | Fallo del sensor | 3 h | 1.5 h | 1.5 h |
| F03 | Atasco mecánico | 1 h | 0.5 h | 0.5 h |
| F04 | Fallo del sensor | 2 h | 1 h | 1 h |
| Total | 4 fallos | 8 h | 4 h | 4 h |
Calcula el MTBF y el MTTR a partir de los dos registros
El manual de ingeniería de NIST estima el MTBF dividiendo el tiempo operativo total entre la cantidad de fallos bajo su modelo de tasa constante. Para nuestro registro observado, el cálculo es 140 ÷ 4 = 35 horas. Utilizar las horas planificadas 160 incluiría incorrectamente el tiempo en que el equipo no estaba operando.
MTTR = 8 ÷ 4 = 2 horas. La media de mantenimiento activo es 4 ÷ 4 = 1 hora. El primer dato describe toda la recuperación y el segundo el trabajo efectivo. Etiquétalos de forma distinta.
Datos ilustrativos. El numerador y la cantidad de eventos utilizan un activo y una cohorte de fallos completamente observada y emparejada.
Compara frecuencia y duración juntos
Compara ahora un segundo equipo ficticio con las mismas horas en marcha y pérdida total, pero ocho fallos más cortos. Pierde el mismo tiempo y provoca el doble de interrupciones.
Usa este patrón para elegir qué investigar. Las fallos repetidas pueden justificar una investigación de causa raíz; las recuperaciones largas pueden justificar un análisis más cercano del diagnóstico, el acceso o los retrasos. Ningún promedio prueba la causa ni la mejor solución. Revisa los eventos individuales y su impacto en la producción con un Pareto de paradas.
| Activo | Horas de operación | Fallas | Horas de restauración | MTBF | MTTR |
|---|---|---|---|---|---|
| PKG-01 | 140 | 4 | 8 | 35 h | 2 h |
| Activo de comparación | 140 | 8 | 8 | 17.5 h | 1 h |
Mantén la disponibilidad del OEE en tu propio denominador
La explicación del OEE de Vrolen define la disponibilidad como el tiempo de ejecución dividido por el tiempo de producción planificado. Incluye los cambios de referencia registrados y las faltas de material, así como los fallos del equipo. En este ejemplo, la disponibilidad del OEE es 140 ÷ 160 = 87.5%.
Si solo consideramos el tiempo de funcionamiento y el tiempo de restauración tras la falla, la cuota de tiempo operativo es 140 ÷ (140 + 8) = 94.6%. La relación 35 ÷ (35 + 2) da el mismo resultado porque estos registros utilizan las mismas cuatro fallos completamente observadas. Deja fuera las doce horas de otras paradas, por lo que no puede reemplazar la disponibilidad del OEE.
Trata esto como un ejemplo emparejado, no como una predicción universal de disponibilidad. Diferentes cohortes de eventos o retrasos excluidos pueden romper la comparación. La disponibilidad también es solo un factor del OEE; las pérdidas de velocidad y los rechazos aún importan. Consulta el cálculo completo OEE.
140 h funcionando + 8 h fallos + 12 h otras paradas = 160 h. La cifra de solo fallos 94.6% utiliza un denominador diferente.
Informa de periodos sin fallos y recuperaciones abiertas
Con cero fallos, informe las horas de operación observadas y cero eventos. No presente un MTBF cero o una cifra infinita como prueba de confiabilidad perfecta. NIST proporciona límites de confianza basados en modelos para ese caso; una ventana libre de fallos corta da evidencia limitada.
Conserva los eventos abiertos. No inventes una hora de vuelta al servicio usando el cierre del informe ni retires una recuperación larga del historial. La media de eventos terminados puede mejorar mientras el peor fallo sigue abierto. Muestra su número y antigüedad.
Para una parada que cruza un límite de informe, conserve el evento completo y asigne solo el tiempo perdido superpuesto al cálculo del OEE de esa ventana. Documenta la convención de conteo de eventos para el MTBF. Una cohorte de conteo de fallos y una cohorte de restauración completada pueden diferir, por lo que no introduzca sus promedios en la relación simple de disponibilidad sin reconciliarlos.
Usa los números para elegir la siguiente investigación
Antes de comparar turnos, máquinas o meses, verifique la mezcla de productos, el turno, los modos de operación y la definición de fallo. Cuatro eventos son un punto de partida para una investigación, no una estimación confiable de las pérdidas del próximo mes.
Una mejora en el mantenimiento es relevante para la producción cuando reduce una interrupción significativa. Mantén separados el origen y el impacto aguas abajo, como en seguimiento del tiempo de inactividad de la producción. Un fallo en un activo con buffer puede tener consecuencias diferentes a uno en la restricción actual de la línea.
El mantenimiento predictivo también se beneficia de registros que distinguen fallos confirmados, síntomas y exposición operativa. Empieza haciendo que los números de esta semana sean reproducibles antes de usarlos para entrenar un modelo o justificar nuevos gastos.
- Acuerda las medidas de tiempo
Define con operaciones y mantenimiento horas en marcha, fallo, retorno al servicio y trabajo activo.
- Comprueba ambos registros
Revisa equipos, horas, solapamientos y balance del tiempo planificado. Conserva los eventos abiertos.
- Muestra recuentos junto a medias
Informa de horas en marcha, fallos, recuperaciones terminadas y abiertas junto a MTBF y MTTR.
- Investiga el patrón
Revisa síntomas repetidos, recuperaciones largas y retrasos registrados antes de elegir una medida.
- Comprueba el efecto en producción
Verifica si disminuye pérdidas relevantes en condiciones comparables y con procedimientos de planta aprobados.
Lista práctica
- Define la función requerida y qué cuenta como fallo.
- Usa el mismo equipo y periodo para ambos registros.
- Declara si MTTR mide recuperación completa o reparación activa.
- Separa mantenimiento activo, respuesta y espera.
- Conserva zonas horarias y pruebas rastreables.
- Elimina duplicados y resuelve solapamientos.
- Muestra horas sin fallos y eventos abiertos sin inventar duraciones.
- Separa fallos de cambios y otras paradas.
- Acompaña medias con recuentos y dispersión de duraciones.
- Comprueba el efecto en producción antes de afirmar una mejora.
Preguntas frecuentes
Preguntas frecuentes
Fuentes y lecturas
Referencias autorizadas utilizadas para investigar y verificar esta guía.