
Hay fuga de datos en IA industrial cuando el desarrollo o la evaluación usa información no disponible para la decisión prevista, o deja cruzar registros dependientes por un límite que debía representar producción nueva. Separa conjuntos según el uso real, considerando tiempo, pieza y lote cuando corresponda, y ajusta el preprocesamiento solo con entrenamiento. Este registro ficticio de imágenes revela una división aleatoria engañosa sin inventar puntuaciones ni afirmar que una única separación valide todos los modelos de fábrica.
Comprueba si cada variable existe al tomar la decisión.
Evita que imágenes de una misma pieza contaminen la evaluación.
Adapta los límites de tiempo y grupo al uso previsto.
Escribe el momento de predicción en la primera línea del planteamiento
Supón que el modelo decide si señalar una pieza justo después de capturar su imagen. Puede usar información realmente disponible en ese momento. El resultado posterior de inspección final puede ser la etiqueta objetivo, pero no una entrada de esa decisión anterior.
Scikit-learn define la fuga mediante información no disponible al predecir y advierte contra aprender el preprocesamiento del conjunto de prueba. En planta hay que seguir disponibilidad y relaciones, no simplemente quitar una columna de nombre sospechoso.
| Campo candidato | ¿Disponible al decidir con la cámara? | Tratamiento del ejemplo |
|---|---|---|
| Imagen actual | Sí | Entrada posible tras validar el método |
| Lectura anterior de máquina | Solo si llegó realmente y es válida | Verificar marca de tiempo y latencia |
| Decisión de inspección final | No | Objetivo o referencia posterior, nunca entrada anterior |
| Rendimiento al final del turno | No | Excluir de esta decisión |
| ID de lote | Conocido, pero puede dar atajos | Revisar adecuación al uso y agrupación |
Comprueba cómo la división de imágenes filtra la identidad de pieza
El registro ficticio tiene 8 piezas físicas de 4 lotes sucesivos, 2 por lote, con 3 imágenes por pieza: 24 imágenes. Una división tentadora asigna las imágenes 1 y 2 de cada pieza al entrenamiento y la 3 a la prueba.
Así hay 16 imágenes de entrenamiento y 8 de prueba, pero todas las piezas de prueba ya se vieron al entrenar. Puede evaluar otra vista de piezas conocidas, no el rendimiento en piezas nuevas. No se comunica puntuación porque no se entrenó ningún modelo; el fallo está en lo que representa la separación.
Separa los conjuntos según la pregunta sobre lotes nuevos
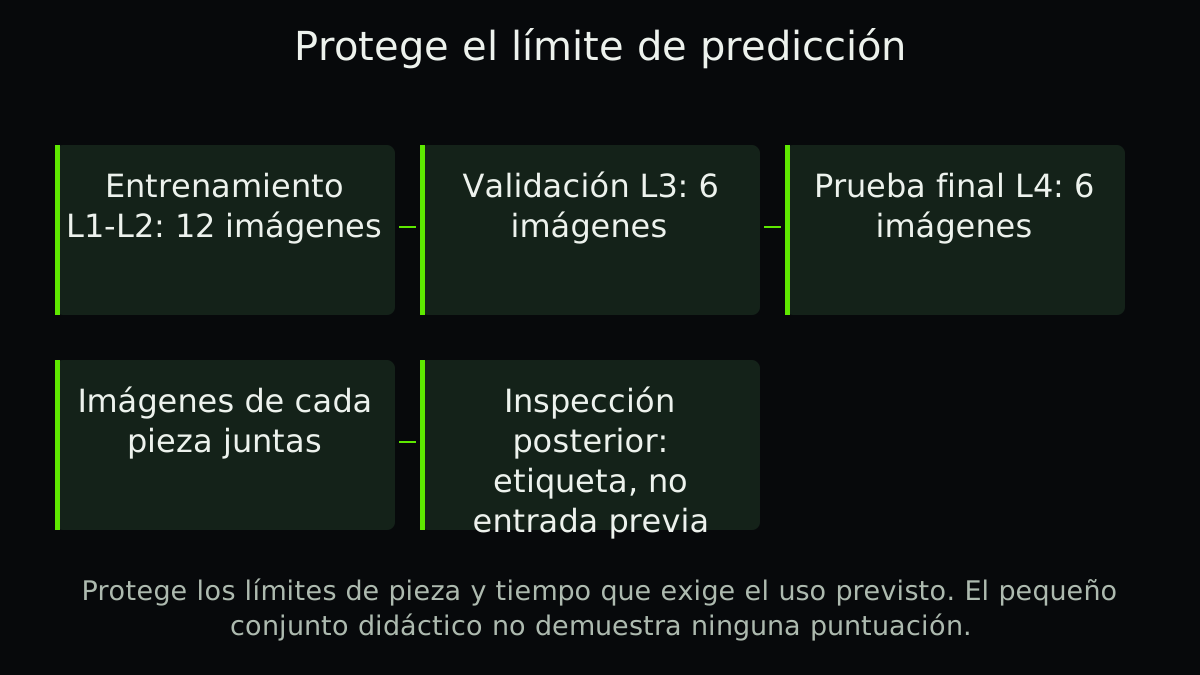
Para una evaluación didáctica de lotes nuevos en orden temporal, asigna L1 y L2 a entrenamiento: 4 piezas y 12 imágenes. Reserva L3 para ajuste: 2 piezas y 6 imágenes. Conserva L4 como prueba final posterior: 2 piezas y 6 imágenes. Ninguna pieza ni lote cruza los límites.
Este conjunto diminuto ilustra separación, no aporta evidencias suficientes para un modelo visual útil. Tampoco establece rendimiento en otra planta o con defectos desconocidos. El uso real necesita más grupos y periodos representativos.
Las 3 imágenes de cada pieza física permanecen juntas. Protege la agrupación declarada, pero esas cantidades pequeñas no validan el rendimiento.
Combina los límites adecuados en vez de dividir por costumbre
Separar por grupos mantiene juntos registros relacionados. Separar por tiempo permite evaluar un periodo posterior. Un separador genérico de grupos no impone cronología automáticamente; uno temporal tampoco evita por sí solo que una pieza o lote de larga duración cruce el límite.
Conserva las asignaciones reales de grupo y tiempo y compruébalas directamente. Revisa también disponibilidad de etiquetas: entrenar hasta una fecha histórica no permite usar resultados que aún no habían llegado. Ajusta escalado, imputación, selección de variables y parámetros solo con los datos de desarrollo permitidos.
- Define uso y momento de decisión
Declara unidad, objetivo, límite de disponibilidad y población futura que predecir.
- Identifica dependencia y disponibilidad
Localiza piezas repetidas, lotes, máquinas, solapamientos temporales y etiquetas tardías.
- Construye y comprueba la separación
Verifica las exclusiones reales de tiempo y grupo, no solo el nombre del método.
- Protege la evaluación final
No uses los datos reservados para elegir variables, modelo o umbral.
Revisa atajos que sobreviven a una separación aparentemente limpia
Código de lote, fondo de cámara o anotación del operador pueden servir de atajo si se relacionan con el objetivo durante el desarrollo, pero faltan o cambian en uso. Examina fallos representativos y resultados de subgrupos relevantes, no solo una media.
El análisis de concordancia por atributos ayuda a cuestionar etiquetas inconsistentes; los umbrales de inspección permiten comparar defectos no detectados y falsos rechazos. Separar bien los datos no corrige un objetivo mal definido.
Conserva el alcance de evaluación con la versión del modelo
El registro debe identificar qué se sabía y cuándo, qué grupos se excluyeron, qué preprocesamiento se ajustó y quién podía consultar la prueba final. Si la prueba impulsa un rediseño, pasa a ser evidencia de desarrollo y hace falta una evaluación final nueva.
La descarga conserva las asignaciones ficticias de 24 imágenes y los campos de auditoría. No incluye una puntuación de modelo: el ejemplo comprueba la separación, no el rendimiento.
Un ejemplo relacionado de Abolfazl
Compara un registro aparentemente válido con lo que hay en la estantería.
En inglés, en el blog personal del fundador Abolfazl. Es lectura relacionada, no una fuente técnica independiente.
Lista práctica
- Escribe el momento exacto de predicción.
- Verifica disponibilidad y latencia de variables.
- No uses resultados futuros como entradas anteriores.
- Identifica piezas repetidas y lotes compartidos.
- Comprueba límites temporales y de grupo.
- Ajusta preprocesamiento con entrenamiento permitido.
- No uses la prueba final para ajustar umbrales.
- Informa de unidades independientes y límites junto a las filas.
Preguntas frecuentes
Preguntas frecuentes
Fuentes y lecturas
Referencias autorizadas utilizadas para investigar y verificar esta guía.