
Wählen Sie einen KI-Prüfschwellenwert anhand übersehener Fehler, falscher Ablehnungen und ihrer Folgen auf repräsentativen, zurückgehaltenen Prüfteilen. Eine höhere Gesamtgenauigkeit kann bei seltenen Fehlerteilen mehr unentdeckte Fehler verdecken. Legen Sie die Entscheidungsregel nach Risiko, Nachprüfkapazität und geltenden Anforderungen fest und validieren Sie sie getrennt vom Modelltraining. Dieses fiktive Beispiel mit 10.000 Teilen vergleicht zwei Schwellenwerte an derselben Gruppe. Das angenommene Kostenmodell unterstützt die Diskussion, nicht die Produktfreigabe.
Die vier Ergebnisse hinter einem Genauigkeitswert lesen.
Schwellenfolgen mit ausdrücklichen Kostenannahmen vergleichen.
Abstimmungsdaten von Endbewertung und Freigabebefugnis trennen.
Die Klasse definieren, die eine Ablehnung auslöst
Positiv bedeutet hier: als fehlerhaft vorhergesagt. Richtig positiv markiert ein fehlerhaftes Teil korrekt. Falsch negativ übersieht eines. Falsch positiv markiert ein gutes Teil, und richtig negativ lässt ein gutes Teil passieren. Nennen Sie die Konvention, bevor Sie eine Konfusionsmatrix lesen.
Scikit-learn trennt Modellbewertung vom Entscheidungsschwellenwert und warnt davor, diesen mit Trainingsdaten abzustimmen. Die Bibliothek liefert Analysemethoden, keine Freigaberegel für die Fertigung. Definieren Sie, wie der Betrieb auf jedes Ergebnis reagiert und wie Referenzeinstufungen entstehen.
Zwei Schwellen an denselben fiktiven Teilen vergleichen
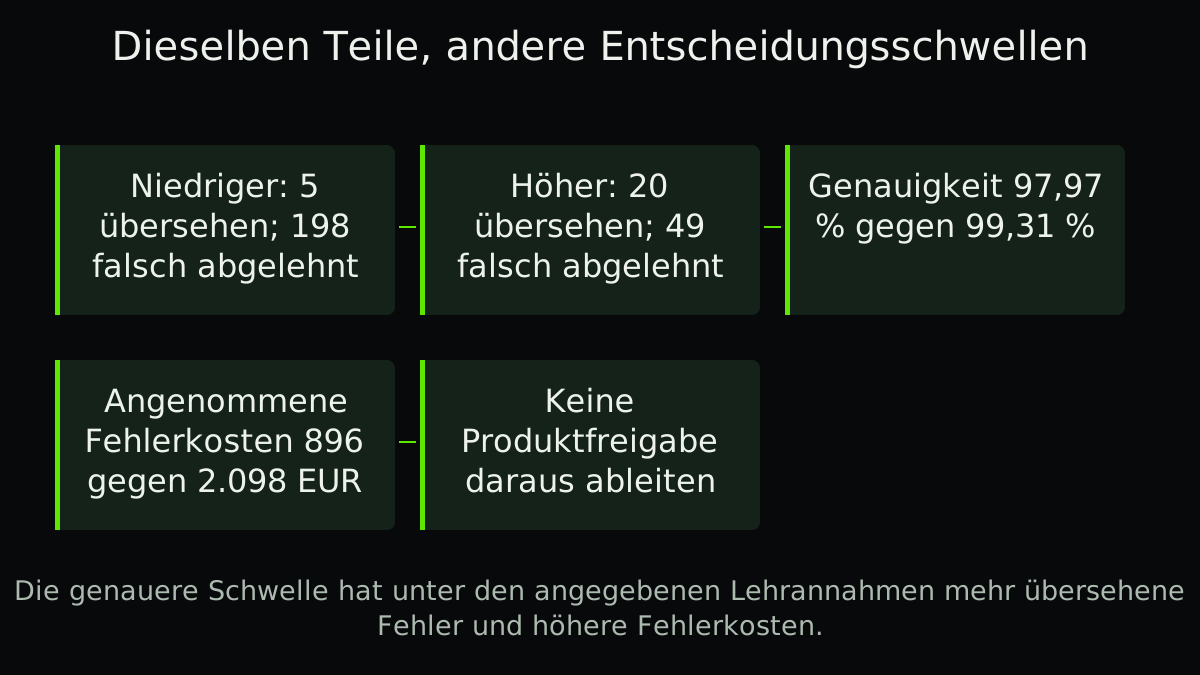
Die illustrative zurückgehaltene Prüfgruppe enthält 10.000 Teile: 100 tatsächlich fehlerhafte und 9.900 gute laut festgelegter Referenz. Bei niedrigerer Schwelle werden 95 Fehlerteile markiert, 5 übersehen und 198 gute Teile fälschlich markiert. Bei höherer Schwelle werden 80 Fehlerteile markiert, 20 übersehen und 49 gute Teile fälschlich markiert.
Beide Matrizen verwenden dieselben Teile und Referenzeinstufungen. Die höhere Schwelle verringert Markierungen, sowohl falsche als auch richtige Fehlermarkierungen. Das ist kein Nachweis eines besseren Modells. Nur die Entscheidungsregel hat sich geändert.
| Ergebnis | Niedrigere Schwelle | Höhere Schwelle |
|---|---|---|
| Richtig positiv: Fehlerteil markiert | 95 | 80 |
| Falsch negativ: Fehlerteil übersehen | 5 | 20 |
| Falsch positiv: Gutteil markiert | 198 | 49 |
| Richtig negativ: Gutteil passiert | 9702 | 9851 |
| Teile gesamt | 10000 | 10000 |
Kennzahlen und angenommene Folgen berechnen
Die Erkennungsrate, auch Recall, beträgt an der niedrigeren Schwelle 95 %, an der höheren 80 %. Die Präzision, also der Fehlerteilanteil unter den Markierungen, beträgt 32,42 % beziehungsweise 62,02 %. Die Gesamtgenauigkeit steigt an der höheren Schwelle von 97,97 % auf 99,31 %, obwohl die übersehenen Fehler von 5 auf 20 zunehmen.
Für den Lehrkostenvergleich nehmen wir 100 EUR je übersehenem Fehler und 2 EUR je falscher Ablehnung an, ohne weitere Kosten. Die niedrigere Schwelle ergibt 5 × 100 + 198 × 2 = 896 EUR. Die höhere ergibt 20 × 100 + 49 × 2 = 2.098 EUR. Das sind Kostenannahmen für das Rechenbeispiel. Ein solches Kostenmodell kann Sicherheits-, Kunden- und Rechtsanforderungen nicht außer Kraft setzen.
Niedriger 896 EUR gegenüber höher 2.098 EUR auf denselben 10.000 Teilen. Der Vergleich lässt weitere Kosten aus und gibt keinen Schwellenwert frei.
Prüfen, was das Team tatsächlich nachprüfen kann
Die niedrigere Schwelle markiert 293 Teile, die höhere 129. Werden Markierungen manuell nachgeprüft, zählen Kapazität und Bearbeitungszeit. Eine wachsende Prüfschlange kann Gutproduktion verzögern; eine hastige Nachprüfung kann dieselben Fehler erneut übersehen.
Klären Sie, ob eine Markierung Nachprüfung, Nacharbeit, Verschrottung oder automatische Freigabesperre bedeutet. Bezeichnen Sie nicht jedes falsch positive Ergebnis als Ausschusskosten, wenn Gutteile nachgeprüft und in die Produktion zurückgegeben werden. Die attributive Übereinstimmungsanalyse untersucht die Beständigkeit menschlicher Referenz- und Nachprüfentscheidungen.
- Ergebnisse und Folgen definieren
Positive Klasse, Referenzmethode, Fehlerschwere und Reaktion auf jedes Ergebnis festlegen.
- Mit geeigneten Validierungsdaten abstimmen
Ein offengelegtes Ziel verwenden und Trainings- von abschließenden Testaufzeichnungen trennen.
- Die endgültige Regel bewerten
Zurückgehaltene teilbezogene Fehler, Unsicherheit, Untergruppen und Nachprüflast prüfen.
- Betrieb validieren und überwachen
Die Entscheidung unter repräsentativen Linienbedingungen bestätigen und freigegebenes Ersatzverhalten bewahren.
Die Bewertung vor einfachen Abkürzungen schützen
Halten Sie wiederholte Bilder desselben Teils und verwandte Chargen aus Überschneidungen zwischen Training und Bewertung heraus, soweit diese den späteren Einsatz nicht abbilden würden. Beziehen Sie relevante Beleuchtung, Produkte und Fehlerschweregrade ein. Der Artikel zu Datenlecks in Fertigungs-KI erklärt die Aufteilungsgrenze.
Der Fehlerteilanteil von 1 % ist hier angenommen. Präzision und Arbeitslast können sich bei verändertem Anteil verschieben, selbst wenn manche klassenbezogenen Raten ähnlich bleiben. Berichten Sie Unsicherheit und genügend Fehlerbeispiele für die tatsächliche Entscheidung. Viele Gutbilder ersetzen keine fehlenden Nachweise zu seltenen Fehlern.
Schwellenstand und Betriebsentscheidung zusammenhalten
Erfassen Sie Modell, Vorverarbeitung, Kameraaufbau, Schwellenwert, Referenzmethode und Gültigkeitsdatum. Überwachen Sie tatsächliche Ergebnisse, sobald Einstufungen eintreffen, auch für anfangs durchgelassene Teile. Wer nur markierte Teile nachprüft, kann falsch negative Ergebnisse verbergen.
Der Download enthält beide fiktiven Konfusionsmatrizen und Felder für Ihre Entscheidungsprüfung. Das Beispiel ist weder Prüfqualifizierung noch Produktfreigabe.
Ein ergänzendes Beispiel von Abolfazl
Detektorgenauigkeit in Teileergebnisse und deren Kosten übersetzen.
Auf Englisch im persönlichen Blog von Gründer Abolfazl. Ergänzende Lektüre, keine unabhängige technische Quelle.
Praxis-Checkliste
- Positive Klasse und Reaktion festlegen.
- Referenzeinstufungen und Schweregrad prüfen.
- Training, Abstimmung und Abschlusstest trennen.
- Alle vier Ergebnisse zählen.
- Fehlerteilanteil und Fehlerabdeckung prüfen.
- Begründete Folgenannahmen verwenden.
- Nachprüfkapazität und Ersatzverfahren testen.
- Schwelle versionieren und verzögerte Ergebnisse überwachen.
Häufige Fragen
Häufige Fragen
Quellen und Vertiefung
Maßgebliche Referenzen für Recherche und Prüfung dieses Leitfadens.